ycliper

Популярное

Музыка Кино и Анимация Автомобили Животные Спорт Путешествия Игры Юмор

Интересные видео

2025 Сериалы Трейлеры Новости Как сделать Видеоуроки Diy своими руками

Топ запросов

смотреть а4 schoolboy runaway турецкий сериал смотреть мультфильмы эдисон

Видео с ютуба Low-Bit Quantization
The myth of 1-bit LLMs | Quantization-Aware Training

The myth of 1-bit LLMs | Quantization-Aware Training

Qwen3: Low-Bit Quantization & Performance
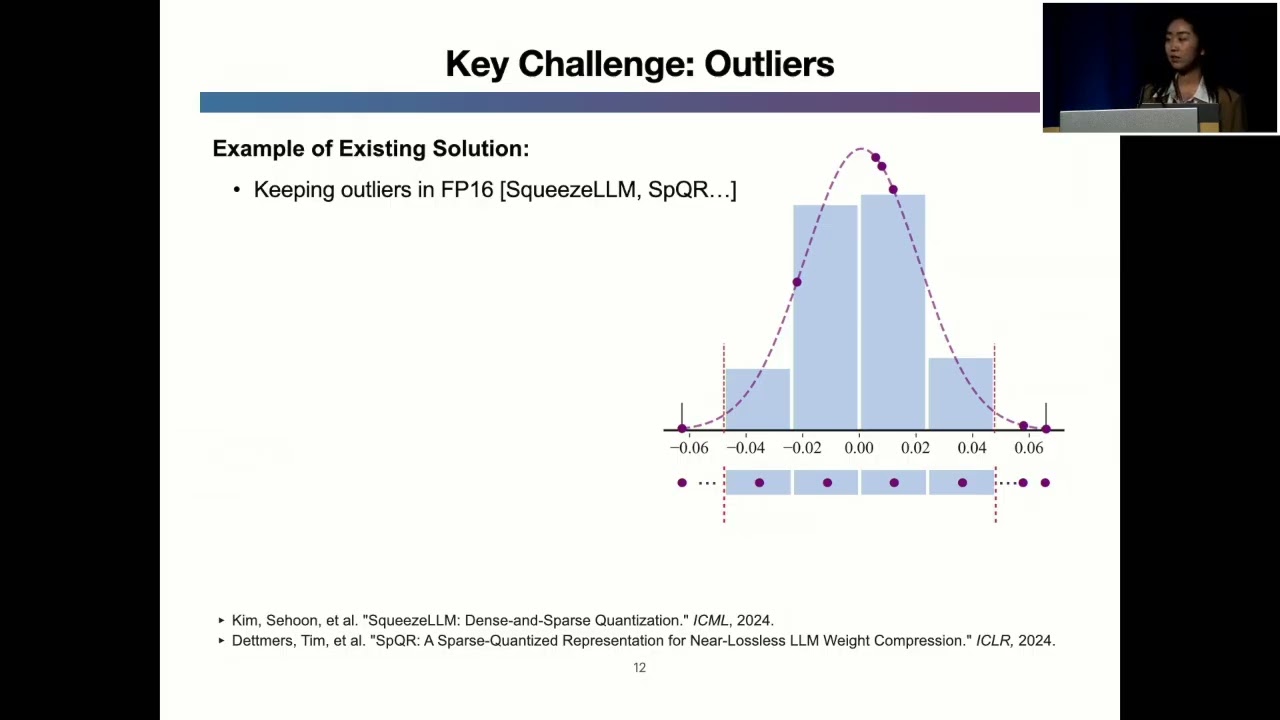
Qwen3: Low-Bit Quantization & Performance

ICQuant: Index Coding enables Low-bit LLM Quantization

ICQuant: Index Coding enables Low-bit LLM Quantization

1-Bit LLM: The Most Efficient LLM Possible?

1-Bit LLM: The Most Efficient LLM Possible?

OSDI '25 — DecDEC: Системный подход к развитию низкобитного квантования LLM
OSDI '25 — DecDEC: Системный подход к развитию низкобитного квантования LLM

Everything looks fine at 4-bit

Everything looks fine at 4-bit

GSQ-RCO: улучшенная неравномерная квантованная GGUF-модель

GSQ-RCO: улучшенная неравномерная квантованная GGUF-модель

Как LLM выживают в условиях низкой точности | Основы квантования

Как LLM выживают в условиях низкой точности | Основы квантования

Лекция 118: GSQ-RCO: Улучшенная неравномерная квантование GGUF

Лекция 118: GSQ-RCO: Улучшенная неравномерная квантование GGUF

Qwen3: Low-Bit Performance Study

Qwen3: Low-Bit Performance Study

INT v.s. FP: A Comprehensive Study of Fine-Grained Low-bit Quantization Formats

INT v.s. FP: A Comprehensive Study of Fine-Grained Low-bit Quantization Formats

Low-bit-width Large-model Quantization Challenge Live replay
Low-bit-width Large-model Quantization Challenge Live replay

Does 1-Bit Quantization Destroy LLM Logic?

Does 1-Bit Quantization Destroy LLM Logic?

LittleBit: ультранизкобитное квантование с помощью латентной факторизации

LittleBit: ультранизкобитное квантование с помощью латентной факторизации

How Effective Are Low bit Quantized LLaMA3 Models? An Empirical Analysis

How Effective Are Low bit Quantized LLaMA3 Models? An Empirical Analysis

tinyML Asia 2021 Dongsoo Lee: Extremely low-bit quantization for Transformers

tinyML Asia 2021 Dongsoo Lee: Extremely low-bit quantization for Transformers

Training models with only 4 bits | Fully-Quantized Training

Training models with only 4 bits | Fully-Quantized Training

4-BIT QUANTIZATION DEEP DIVE | AWQ vs GPTQ vs GGUF: Fitting 70B Models in Consumer VRAM

4-BIT QUANTIZATION DEEP DIVE | AWQ vs GPTQ vs GGUF: Fitting 70B Models in Consumer VRAM

How to Achieve Extreme Low-bit Quantization for LLMs

How to Achieve Extreme Low-bit Quantization for LLMs

Local LLM Quantization: When a Larger Model Is Worth a Low Quant

Local LLM Quantization: When a Larger Model Is Worth a Low Quant

Следующая страница»

© 2025 ycliper. Все права защищены.


  • Контакты
  • О нас
  • Политика конфиденциальности


Контакты для правообладателей: [email protected]